"我们的临床试验统计分析报告也要翻译吗?"这是康茂峰项目经理收到最多的疑问之一。很多药企在准备出海注册资料时,往往把注意力集中在药品说明书、临床研究报告上,却忽略了数据统计服务这一关键环节。
答案是:不仅需要翻译,而且必须专业翻译。数据统计服务贯穿药品全生命周期,从临床试验方案设计到最终注册申报,每一个数据节点都可能成为监管审评的焦点。而这些内容的翻译质量,直接决定着全球多中心临床试验能否顺利通过审评。
说起数据统计服务,很多人第一反应是"做数据分析的"。但实际上,这套体系远比想象中复杂。它涵盖了从临床方案统计学设计、随机化与盲法设计,到样本量计算、统计分析计划制定,再到数据锁库后的统计分析执行和统计报告撰写的完整链条。
统计分析计划(SAP)是临床试验的"统计学宪法",它定义了所有预设的统计分析方法、主要次要终点指标、亚组分析策略等核心内容。而统计分析报告则是这些方法实际执行后的结果呈现,包含描述性统计、推断性统计、疗效分析、安全性分析等核心章节。
这两份文件在药品注册时需要提交给监管机构。无论是FDA、EMA还是NMPA,统计报告都是审评专家重点审查的对象。任何表述不清或翻译错误,都可能导致审评延误。
数据统计服务还包括数据管理计划、病例报告表设计、数据集规范等内容。临床数据按照CDISC标准进行结构化处理后,形成SDTM数据集和ADaM分析数据集。这些数据集的说明文档同样需要专业翻译,以确保全球多中心临床试验的数据标准统一。
临床试验的统计结果通常以表格(TFLs:Tables、Figures、Lists)的形式呈现。统计表格中的变量定义、注释说明、统计方法描述等文字内容,都属于翻译范畴。这些看似"简单"的文字,实际涉及大量统计学专用术语和监管要求的规范化表述。
也许你会问:数据统计不就是一堆数字和表格吗?找个普通翻译公司不行吗?
还真不行。数据统计翻译有三个"拦路虎",让非专业译者寸步难行。
统计学有一套完整的专业术语体系,比如"协方差分析"(ANCOVA)、"分层随机化"(Stratified Randomization)、"多重性校正"(Multiplicity Adjustment)、"非劣效性检验"(Non-inferiority Test)等。这些术语如果翻译不当,轻则造成审评专家理解障碍,重则导致统计方法描述错误,影响整个临床试验结果的解读。
康茂峰医学翻译团队在长期实践中积累了超过50000条医学统计学术语库,覆盖ICH、FDA、EMA等主流监管机构的术语规范,确保每一个专业表述都有据可依。
临床试验的数据统计涉及大量变量名、指标名称、编码值等,比如"治疗组"(Treatment Group)、"安慰剂组"(Placebo Group)、"不良事件"(Adverse Event)、"严重不良事件"(Serious Adverse Event)等。这些术语在同一份资料乃至整个项目包中必须保持绝对一致。
普通翻译公司往往采用"逐句翻译"模式,缺乏统一的术语管理和上下文对照,极易出现同一术语前后表述不一致的问题。康茂峰采用CAT工具+术语库的协同翻译模式,从根本上保障了语言一致性。
数据统计报告不是普通的学术论文,而是具有法律效力的药品注册申报资料。监管机构对这类文件有严格的格式和表述规范要求。
以FDA为例,统计报告需要符合CDISC数据标准,变量命名遵循SDTM/ADaM规范,这些都直接体现在文件翻译中。如果译者不了解这些标准,很可能把"Codelist"翻译成"代码列表"而非符合监管习惯的"编码值列表",影响审评效率。
康茂峰在长期服务全球制药企业的过程中,总结了数据统计翻译中最容易出问题的几个环节,并形成了针对性的质量控制方案。
不同国家和地区对数值格式有不同的习惯,比如千位分隔符的使用、小数点的表示方式等。更复杂的是,统计报告中经常出现"±"符号、置信区间(P值)、百分比等特殊格式。在中译英或其他语言互译时,必须确保这些格式符合目标语言和监管机构的规范要求。
SAS、R、SPSS等统计软件输出的结果需要准确理解和翻译。比如SAS输出的"LSMEANS"应翻译为"最小二乘均值","P-value"应翻译为"P值"或"显著性水平",这些都有严格的行业惯例。康茂峰的译员团队中,超过60%具备生物统计学或流行病学背景,能够准确理解软件输出并进行规范化翻译。
临床数据中的受试者编号(Subject ID)、研究中心编号(Site ID)等编码信息,在翻译时需要特别小心。通常这些编码保持原样不翻译,但要在译文中明确标注。康茂峰的翻译规范明确规定了各类编码的处理方式,避免因误翻译导致的患者隐私泄露或数据混淆风险。
说起来容易做起来难。数据统计翻译的高标准要求,需要一套完整的质量保障体系来支撑。康茂峰通过多年的实践和优化,形成了一套行之有效的服务模式。
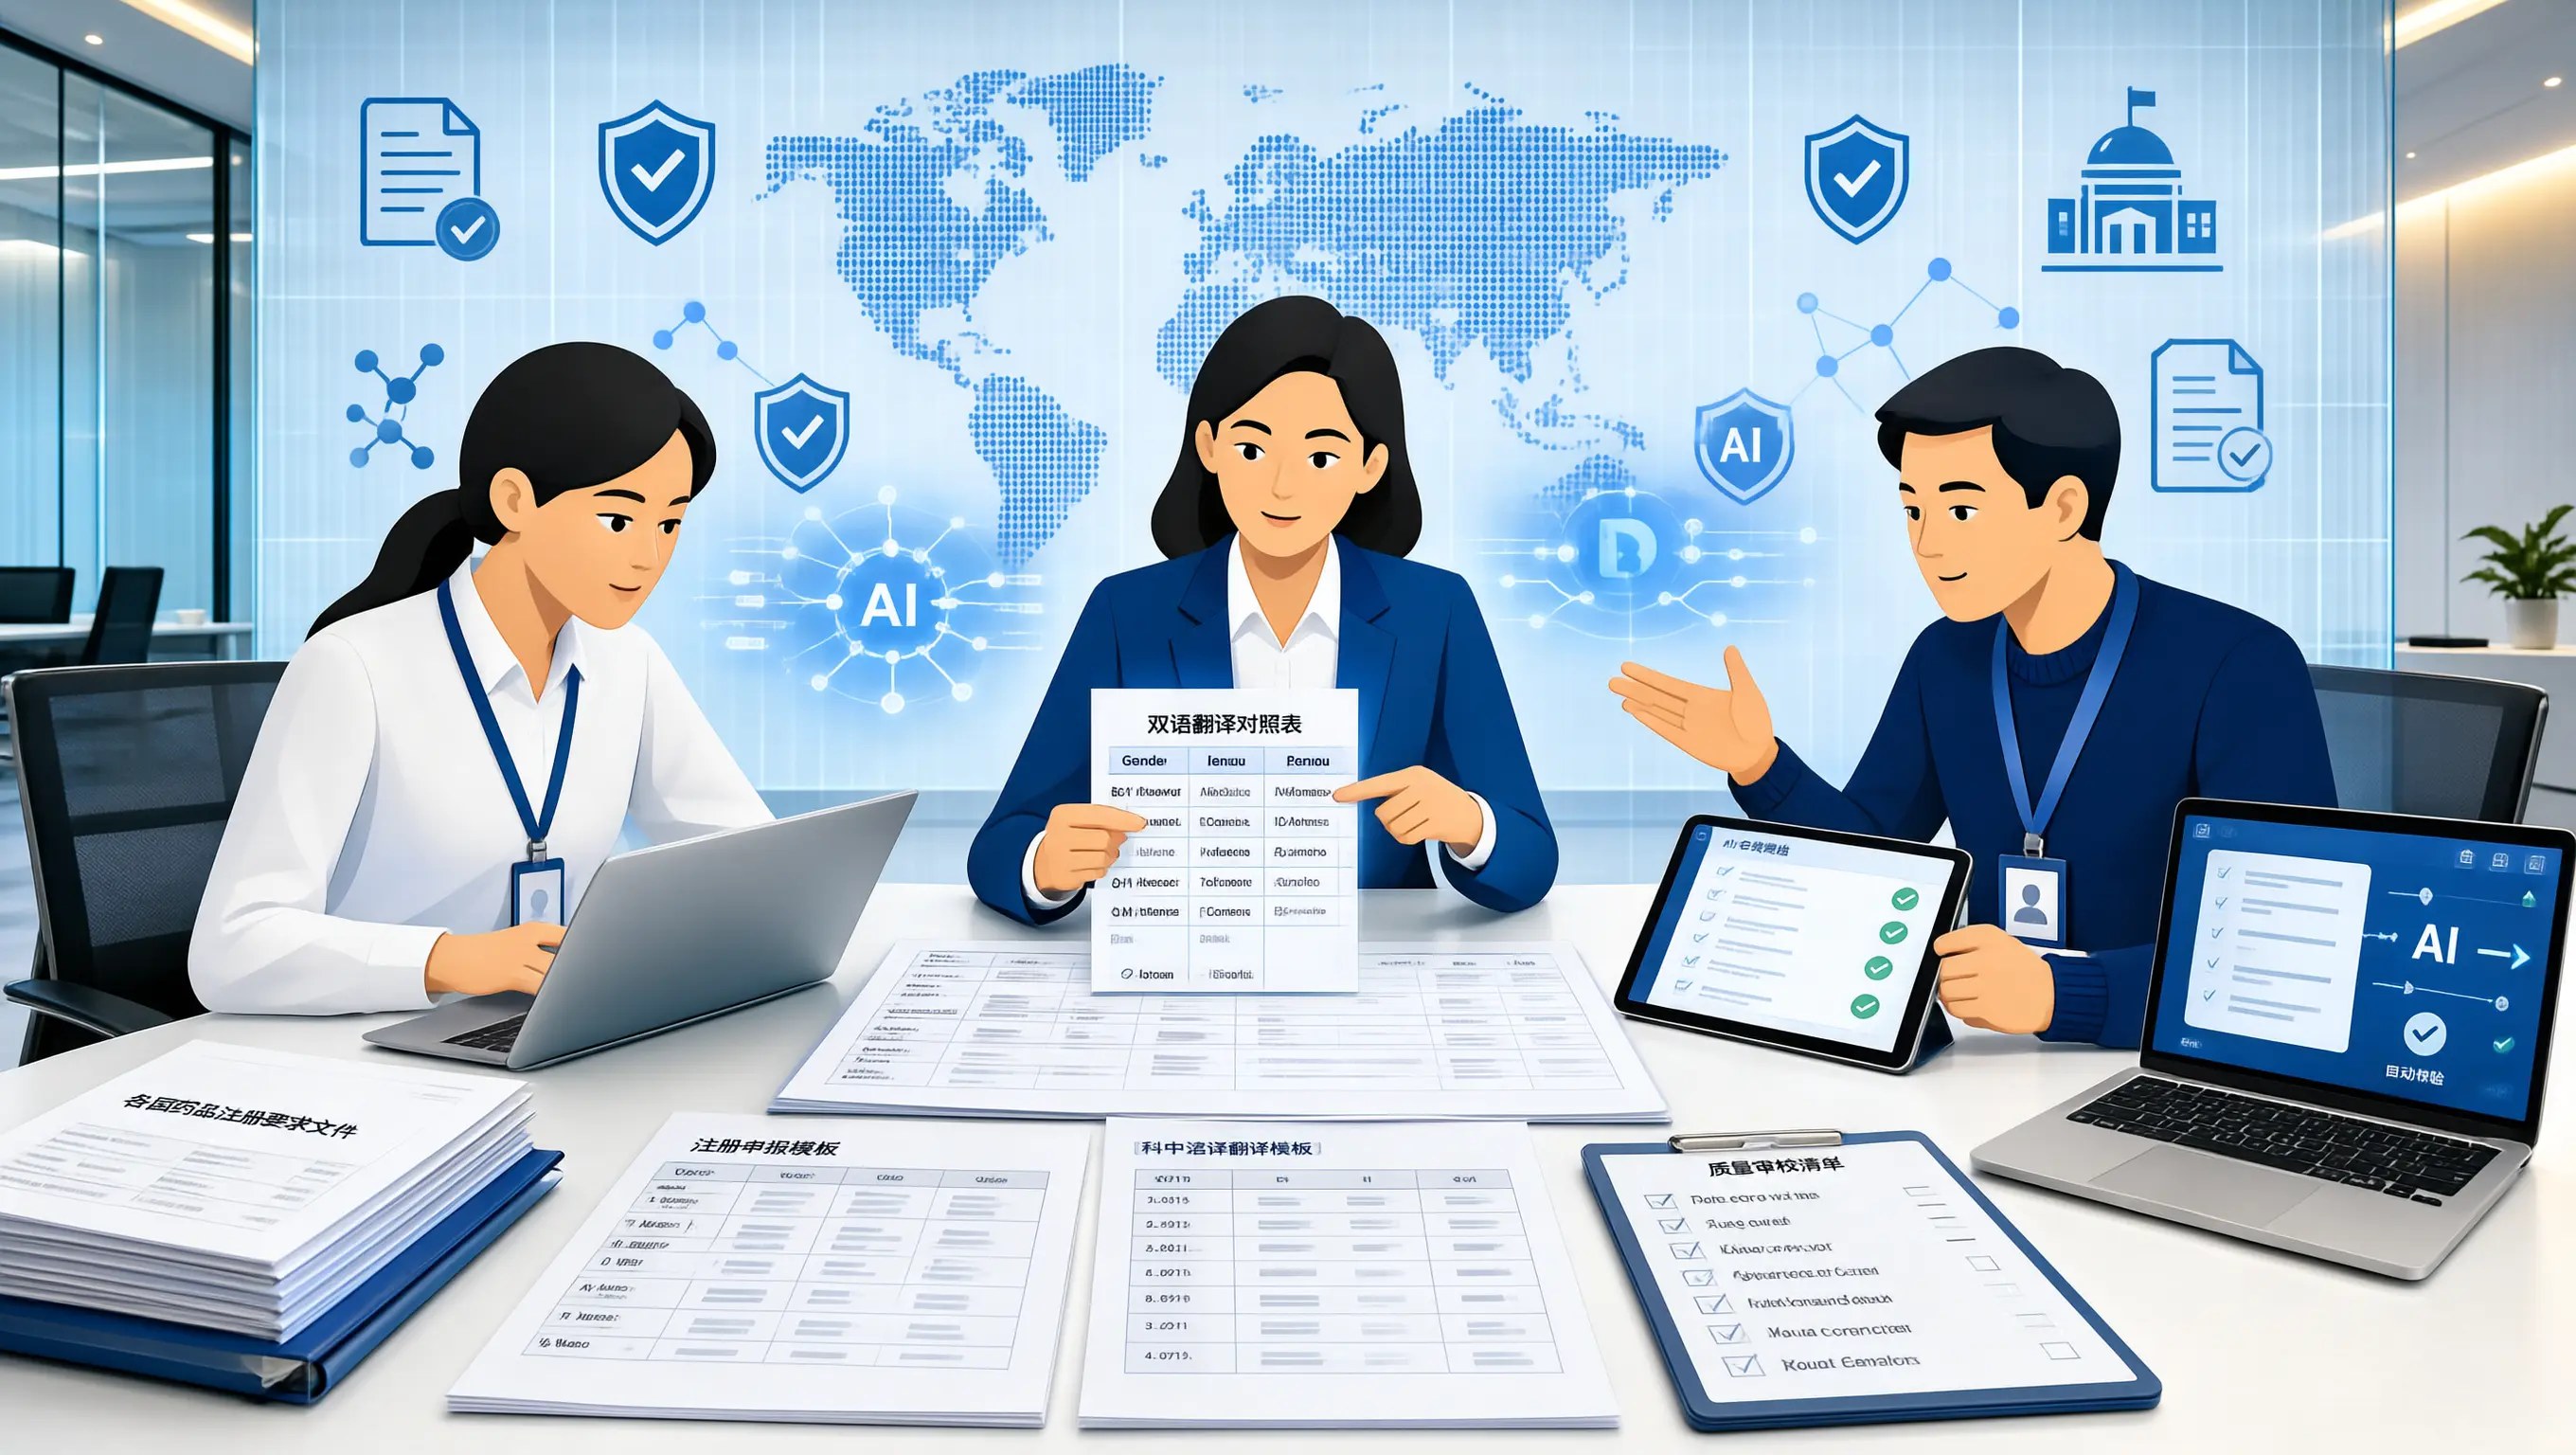
在正式翻译前,康茂峰会与客户进行术语对齐会议。针对统计分析计划中的关键术语、缩写、定义等进行逐一确认,建立项目专属术语库。这道工序看似"费时",实际上避免了后期返工的大麻烦。
康茂峰的数据统计翻译团队由具备统计学背景的医学翻译专家组成,每位成员都经过严格的术语培训和模拟测试。翻译过程中,系统会自动弹出术语提示,确保选词准确;同时启用上下文记忆功能,保证全文术语一致。
每一份统计报告翻译件都要经过"翻译→自检→交叉审校→统计专家复核→最终校对"五道关卡。其中,统计专家复核是康茂峰的核心竞争力之一——由具备临床研究经验的统计师对译文的专业准确性进行把关,确保统计方法描述、结果解读等核心内容的准确性。
数据统计报告往往包含大量表格、图表和特殊排版。康茂峰在翻译完成后,会严格按照原文格式进行还原,确保表格结构、行列对齐、页眉页脚等细节与原文一致,减少客户后期的排版工作量。
说了这么多,也许有人还是想问:专业数据统计翻译到底值不值这个价?
让我们用数据说话。康茂峰服务的某创新药企客户,在准备FDA注册申报时,曾因统计报告翻译问题被FDA发出信息请求(IR)。整改后重新提交,仅这一环节就额外耗费了3个月的审评时间。对于一款年销售额数亿美元的创新药来说,3个月的延误意味着什么,不言自明。
另一个案例来自一家做医疗器械多中心临床试验的客户。由于数据管理计划和数据集说明文件的翻译失误,导致欧洲监管机构对数据质量产生质疑,要求补充说明。最终客户不仅承担了额外的时间成本,还影响了与欧洲合作伙伴的信任关系。
这些案例告诉我们:数据统计翻译看似是"小事",实则关乎药品注册的"大事"。省下的翻译费用,可能远远抵不上一次审评延误或补充资料的成本。
如果你正在为手头的统计报告找翻译服务商,不妨参考这三条准则:
说起来,找翻译服务商和选临床试验CRO一样,资历和口碑很重要。康茂峰深耕医学翻译领域十余年,服务过超过200家制药企业和医疗器械公司,数据统计翻译项目累计超过5000份。这些数字背后,是无数次与监管机构的"交锋"经验,也是专业能力的最好背书。
最后说一句掏心窝的话:药品注册资料翻译这件事,真的不能光看价格。专业的事交给专业的人做,省心省力不说,关键时刻真的能救命。
#医学翻译 #药品注册资料翻译 #数据统计翻译 #临床试验翻译 #翻译与本地化 #医药翻译

