"这份研究者手册的知情同意部分翻完了,但你知道方案还在改吗?"当某创新药企的临床运营负责人对着电话那头叹气时,电话这头的康茂峰项目经理已经默默打开了版本追踪表。这不是个例。在临床运营的实际战场上,翻译从来不是"等甲方说完再动笔"的被动角色——它是整个项目链条里,最需要提前半步卡位的齿轮。
很多人以为翻译只是"文字转换",但在临床运营语境里,这个认知差点让项目翻车。2019年某PD-1抑制剂的国际多中心临床试验中,中国某中心因为知情同意书的本地化版本与原版存在术语偏差,导致入组延误了三周——监管机构认为受试者可能对风险描述产生误解。这三周的代价,换算成患者入组成本和试验进度损失,够再翻一千份研究者手册。
临床运营的核心特征是"多线程并行":方案设计、中心启动、受试者招募、数据录入、安全性评估同步推进。翻译任务不是这条链条上的最后一个环节,而是散落在每个节点之间的"连接器"。当连接器尺寸不对,整条链都得重新校准。
临床试验有严格的时间节点。某款心脑血管创新药在申请优先审评审批时,FDA要求在45天内提交完整的临床数据补充材料——包括所有研究中心的安全报告更新。这45天里,康茂峰需要完成超过200份安全性报告的本地化翻译、格式调整为eCTD结构、通过质量审校后提交。
这不是"加急费用"能解决的问题。如果翻译团队不知道这个时间窗口从哪天开始倒计时,就会在第30天才发现还有50份文件躺在服务器里没人碰。这就是为什么康茂峰的项目经理在项目启动会上问的第一句话永远是:"监管机构的审批截止日是哪天?"
临床试验数据需要统一编码。MedDRA编码、WHO-ART术语、申办方自定义的药物编码——这些都需要在源文件翻译时就锁定对应的目标语言术语。一个常见的问题是:源文件里用了"头痛",目标文件里出现"头疼"或"头部疼痛",在数据清理阶段就会被识别为不一致条目,增加额外的人工核查成本。
康茂峰的解决方案是在项目启动阶段就建立"术语资产库"——涵盖所有预期出现的医学术语、给药方式、不良事件描述的标准化译法。这个资产库不是翻译完一份文件就扔掉的临时工,而是跟着整个临床项目走完全生命周期的长期资产。
说起来,翻译和临床运营的配合不是从"你给我文件就开始翻"这个节点才开始的。真正的配合,从临床试验方案定稿前的预判阶段就已经埋下伏笔。
当临床运营团队还在和研究者讨论试验设计时,翻译团队已经在做另一件事——扫描方案草案,提前识别可能存在本地化风险的术语和表述。
比如,某些靶向药物的作用机制描述在英文里用了大量隐喻("molecular brake"、"cancer cell hijacking"),直译成中文会让研究者觉得不知所云。这类表述需要在方案设计阶段就定好改写策略,而不是等到知情同意书版本已经锁定后才临时改。
康茂峰在这一阶段的输出物包括:术语风险评估表、预期翻译难点清单、需要临床运营与医学团队确认的表述问题清单。这份清单不是挑刺,而是帮运营团队在方案锁定前把"坑"填平。
多中心临床试验最难管的不是文件多,而是"同一批文件的不同版本"在不同中心之间流转。一家中心收到的是v2.0版知情同意书,另一家中心还在用v1.3——这种版本混乱在翻译层面会被放大,因为v2.0可能只改了两句话,但如果翻译团队不知道哪个版本才是最新官方版,就会出现"新版内容用了旧版译法"的低级错误。
康茂峰在中心启动阶段提供的是"版本锚定"服务:每批翻译交付物都标注源文件版本号、翻译完成时间、当前有效版本标识。运营团队只需要认准"康茂峰版本标签",不用在邮件往来里扒拉找哪个版本是最新的。
此外,中心启动涉及大量本地法规适配文件——如中国GCP要求的研究者简历格式、日本PMDA要求的设施设备清单模板、韩国MFDS要求的试验用药管理流程说明。这些文件不是通用翻译能搞定的,需要懂当地监管要求的本地化团队配合。
病例报告表的本地化翻译听起来简单,做起来全是细节。CRF里每个数据字段的注释都需要翻译,但注释里的"实验室正常值范围"、"样本采集注意事项"、"单位换算说明"都有专业门槛。
更麻烦的是不同中心使用的检验设备可能来自不同厂商,检测方法学存在差异,导致同一检验项目在不同中心的参考值范围不同。这些差异需要体现在CRF注释里,而不是"统一翻译一个固定范围了事"。康茂峰的处理方式是:先请运营团队提供各中心检验设备清单,再针对每家中心的具体参数定制注释翻译。
当临床试验数据需要提交给监管机构时,翻译工作就进入了最高压力模式。以FDA的eCTD申报为例,每个模块的文件夹结构、文件命名规则、序列号编排都有严格规范。翻译完的文件必须重新按照eCTD的模块结构组织,并生成正确的XML backbone。
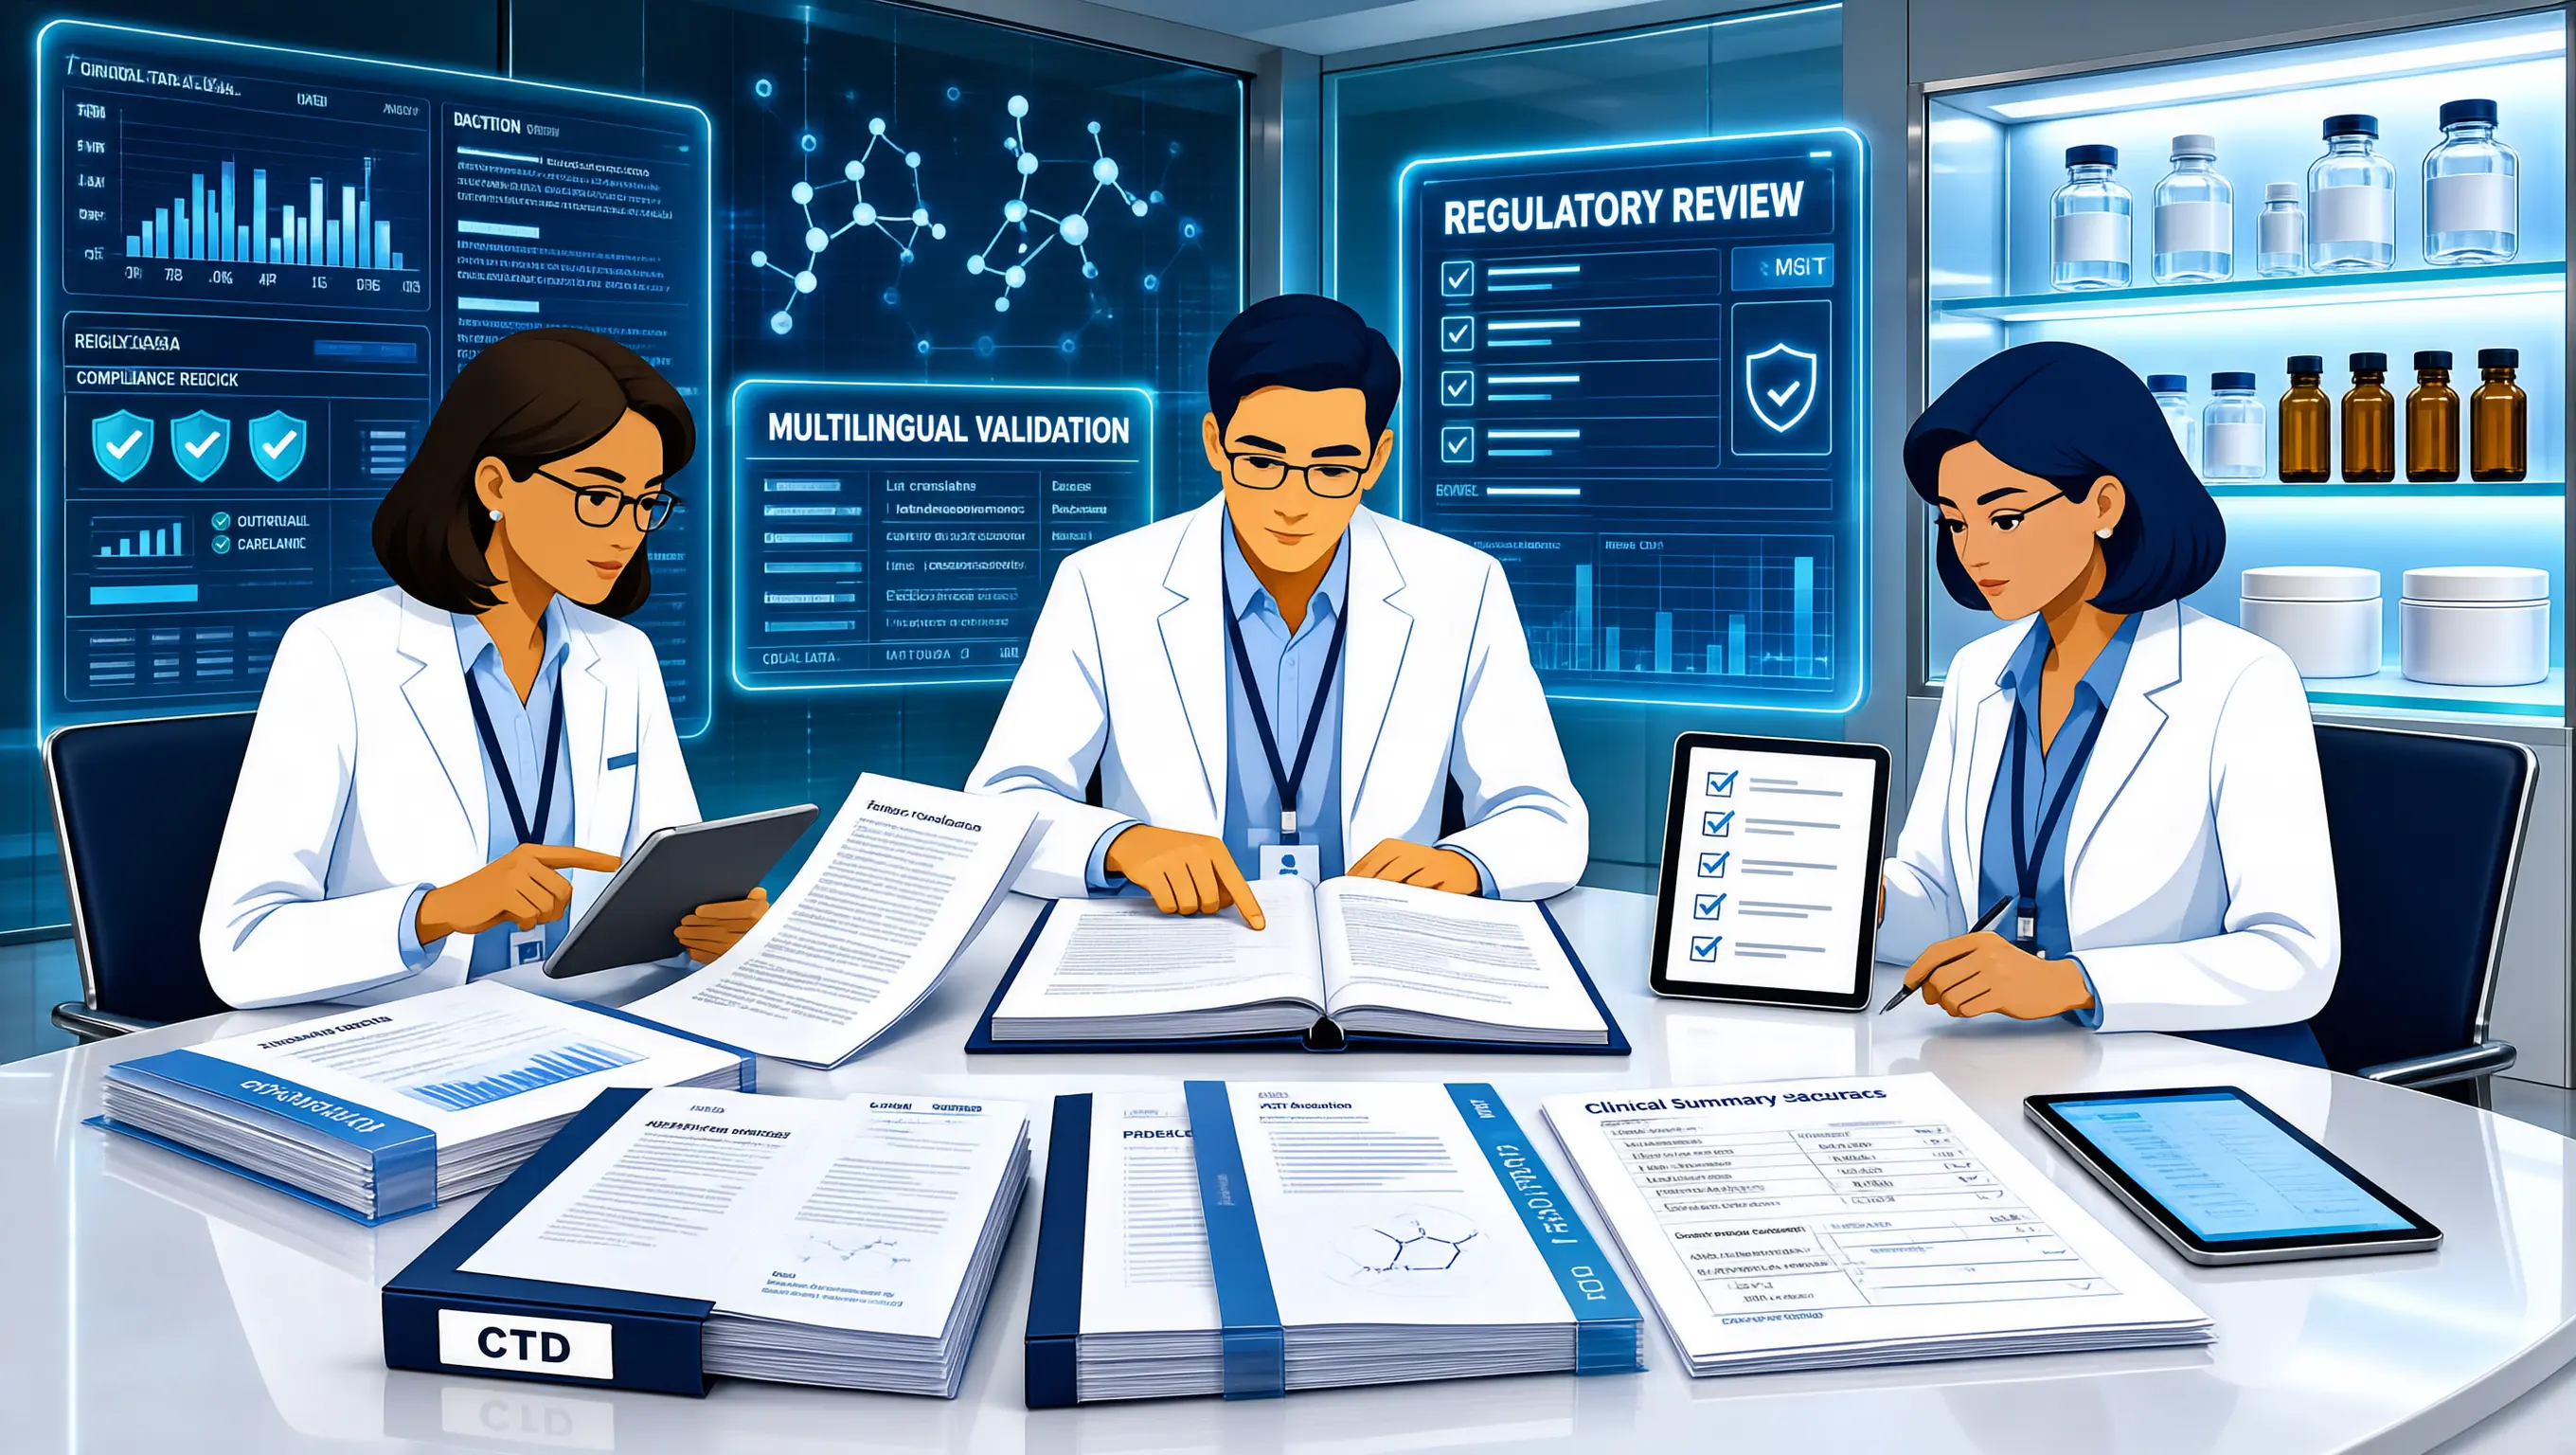
康茂峰的eCTD团队在这一阶段扮演的是"最后守门人"角色:确认所有翻译文件的格式符合目标监管机构的技术要求、交叉检查所有文件之间的引用关系、验证元数据完整性。
运营团队在选择翻译供应商时,最常问的一个问题是:"你们怎么保证质量?"这个问题太大,很难用一句话回答。但康茂峰的经验是:质量不是靠"我们很认真"这句话保证的,而是靠可量化、可追溯、可复现的流程管控。
在临床翻译项目里,术语一致性比"文笔优美"更重要。康茂峰的内部质量审核标准是:同一项目内,相同术语在不同文件中的译法一致率必须达到98%以上。未达标的项目需要返工重新对齐。
这项指标怎么验证?康茂峰使用了术语对齐工具,自动扫描所有已交付文件中的术语使用情况,生成术语一致性报告。这份报告会在项目复盘时提交给运营团队,作为质量保证的客观证据。
运营团队最怕的一件事是什么?是监管机构发来问询函,问某个数据点为什么在某月某日的版本里是A,但在另一份报告里引用的是B。这不是翻译错误,但会引发对整个项目数据完整性的质疑。
康茂峰建立了完整的文件版本追溯体系:每个翻译文件都关联到对应的源文件版本、翻译时间戳、审校记录、交付时间、交付版本号。当运营团队需要向监管机构解释某个数据差异时,只需要调取康茂峰的追溯记录。
临床运营的节奏不是匀速的。有时候一周都没什么动静,有时候凌晨两点突然冒出一个"监管机构要求补充材料,明天就要"。翻译供应商的响应能力,在这种时刻就成了项目能不能按时推进的关键变量。
康茂峰建立了紧急需求分级机制:普通需求24小时响应、加急需求4小时响应、紧急需求1小时响应。每个等级对应的资源配置、价格体系、交付标准都提前告知运营团队,让他们心里有数。
| 临床运营阶段 | 翻译配合内容 | 关键交付物 | 风险预警点 |
|---|---|---|---|
| 方案设计期 | 术语预埋、风险评估 | 术语库草案、难点清单 | 监管机构特殊要求表述 |
| 伦理审批期 | 知情同意书本地化 | 本地化版本、监管适配说明 | 法规更新后的版本差异 |
| 中心启动期 | 多语言文件包交付 | 版本锚定表、文件清单 | 版本混乱导致的重复翻译 |
| 数据收集期 | CRF注释、实验室术语 | 统一术语表、注释翻译件 | 设备差异导致的参考值偏差 |
| 安全报告期 | SAE/SUSAR报告翻译 | 标准化译法、快速交付 | 15天/7天报告的时效要求 |
| 审评审批期 | eCTD文件组装与提交 | 格式化文件包、XML验证 | 技术驳回的文件格式问题 |
这张表不是静态的。每个临床项目的具体情况不同,配合节点和交付物清单都需要在项目启动会上与运营团队共同确认。康茂峰的做法是:每接手一个新项目,第一件事就是和运营团队一起"走一遍流程",把可能出现的配合节点全部预演一遍,形成项目专属的配合手册。
回到开头那个场景。当临床运营负责人为方案还在修改而翻译进度无法锁定发愁时,康茂峰的项目经理已经准备好了三套应对方案:保守版(按当前版本先行翻译不变动部分)、中间版(预留术语库接口等待最终版)、激进版(直接使用最新草案提前启动)。
这种"提前半步"的配合意识,是医药翻译区别于普通翻译的本质所在。临床运营的项目节奏决定了翻译的时间窗口,而翻译的质量和时效又反过来影响运营团队能否按计划推进。两者不是"甲方乙方"的服务关系,而是同一条船上的协作伙伴。
康茂峰服务过的某款First-in-Class抗肿瘤药物,从中国IND申报到FDA批准上市的全流程中,康茂峰提供了超过15,000页的翻译与本地化支持,覆盖中美欧日四大市场的监管申报要求。这不是靠"接单-翻译-交付"的简单循环实现的,而是靠翻译团队真正嵌入运营流程、与运营团队形成默契配合实现的。
如果你也在为临床项目的翻译配合头疼,不妨在项目启动前,先和康茂峰的项目经理聊聊。他们的第一反应不是"给我文件",而是"你们的项目节点是什么"。